

USEARCH - 序列分析软件
USEARCH 12 - 序列分析软件
面向序列检索、聚类与扩增子分析的命令行工具
USEARCH 将序列比对与检索、UCLUST 聚类、FASTQ 读段处理、UPARSE OTU 分析、UNOISE 去噪、UCHIME 嵌合体检测和 SINTAX 分类整合在一套命令行程序中,适合构建可复用的生物信息分析流程。
单一可执行文件,便于在本地工作站或自动化流程中部署。
USEARCH 12 是该工具的首个开源版本,以 GPL-3.0 许可证发布。程序采用命令行方式运行,无图形界面,也不依赖额外运行时组件;用户可根据输入数据、分析目标和计算平台组合相应命令。
核心功能
序列搜索与比对
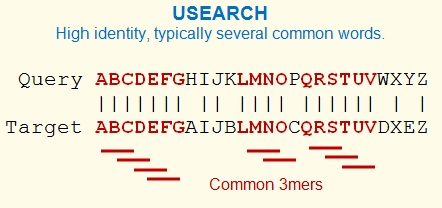
通过 usearch_global 和 usearch_local 执行全局或局部搜索,可按相似度阈值检索数据库并输出匹配结果。
UCLUST 序列聚类
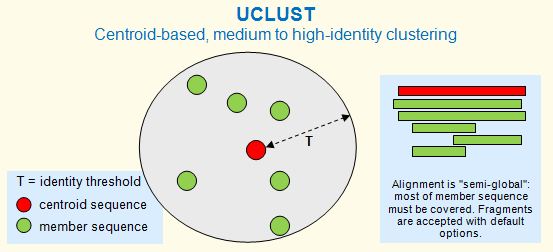
提供 cluster_fast、cluster_smallmem 和 cluster_mt 等命令,用于按序列相似性形成聚类,并适配不同的数据规模与计算方式。
FASTQ 读段处理
可合并双端读段、按质量过滤序列、截取或转换 FASTA/FASTQ 数据,为后续扩增子分析准备输入。
序列去重
使用 fastx_uniques 识别唯一序列并记录丰度信息,减少重复读段,为聚类、去噪和嵌合体检测提供输入。
UPARSE OTU 分析
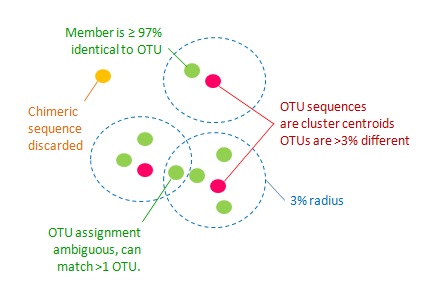
cluster_otus 用于从质量过滤后的唯一序列构建 OTU;uparse_ref 可将查询序列与参考数据库结合开展分析。
UNOISE 序列去噪
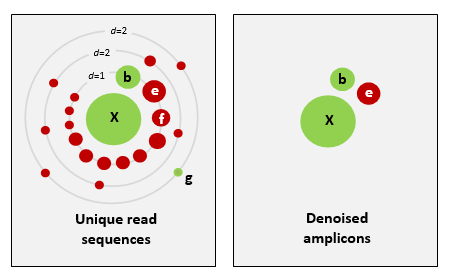
unoise3 根据唯一序列及丰度信息进行去噪,生成用于扩增子研究的零半径 OTU,也可作为 ASV 序列使用。
UCHIME 嵌合体检测
uchime3_denovo 采用从头方式识别扩增子序列中的嵌合体,便于在下游统计前清理候选序列。
SINTAX 分类
sintax 通过参考序列数据库完成分类预测,并可用 sintax_summary 汇总分类结果。
典型分析流程
算法与处理方式
适用场景
微生物扩增子研究
处理 16S、ITS 等扩增子读段,组织从质量控制、去重到 OTU 或 ASV 生成的分析流程。
序列数据库检索
将查询序列与参考库进行全局或局部匹配,用于同源序列查找、注释准备和结果筛选。
序列聚类与去冗余
按相似度对核酸或蛋白质序列进行聚类,整理代表序列并减少数据集中的重复内容。
可复用分析流水线
将独立命令写入 Shell、批处理或其他自动化脚本,适配批量样本和重复运行需求。
平台与使用说明
运行方式
程序为命令行工具,不提供图形界面。单一可执行文件无需安装器、配置文件、环境变量或第三方运行时依赖。
平台构建
预编译程序覆盖 Windows、Linux x86-64、Linux ARM64、macOS Intel 与 Apple Silicon;也可按项目说明从源代码构建。
功能边界
当前版本聚焦序列处理、搜索、聚类与扩增子分析,不包含旧版中的 OTU 表操作和多样性分析模块,可将输出接入后续统计工具。
数据与参数
命令参数、输入格式和输出文件随任务而异;部署前应结合测序平台、读段方向、参考数据库和质量要求设计流程。
服务支持
可提供安装部署、分析流程梳理、命令参数配置、数据预处理、脚本集成及问题排查等技术服务。开源软件本身可从项目页面获取,相关技术服务范围按项目需求确认。
许可说明
USEARCH 12 的源代码与预编译程序按 GPL-3.0 许可证提供;使用、修改和分发时应遵守相应许可条款。不同构建的命令与平台支持范围可能存在差异,使用前请核对所选程序包。


- 2026-10-22
- 2026-10-21
- 2026-10-20
- 2026-10-14
- 2026-10-14
- 2026-10-12

- 2026-09-20
- 2026-09-20
- 2026-09-09
- 2026-09-06
- 2026-09-05
- 2026-09-04